端侧大模型迈入百万Token时代:断网可用的智能底座意味着什么
信息化行业资讯
端侧通用大模型迎来突破,已有产品原生支持100万Token超长上下文并实现断网可用。基于全国产算力平台训练的轻量模型,正在为工业终端、智能设备与机器人提供“数据不出现场”的智能底座。
当云端大模型还在比拼参数规模时,另一条赛道悄然提速:端侧模型开始支撑真正的生产任务。
端侧模型的三个突破
- 超长上下文:已有端侧通用大模型原生支持100万Token上下文,明显缓解了传统端侧模型长文本碎片化、信息遗漏的问题;
- 断网可用:推理完全在本地完成,弱网、无网环境下依然稳定工作,这对工业现场和应急场景至关重要;
- 全国产化训练:模型基于全国产算力平台全流程训练,依托数万亿Token高质量语料预训练,覆盖智能体、代码生成、数学推理等核心能力。
为什么政企场景需要端侧智能
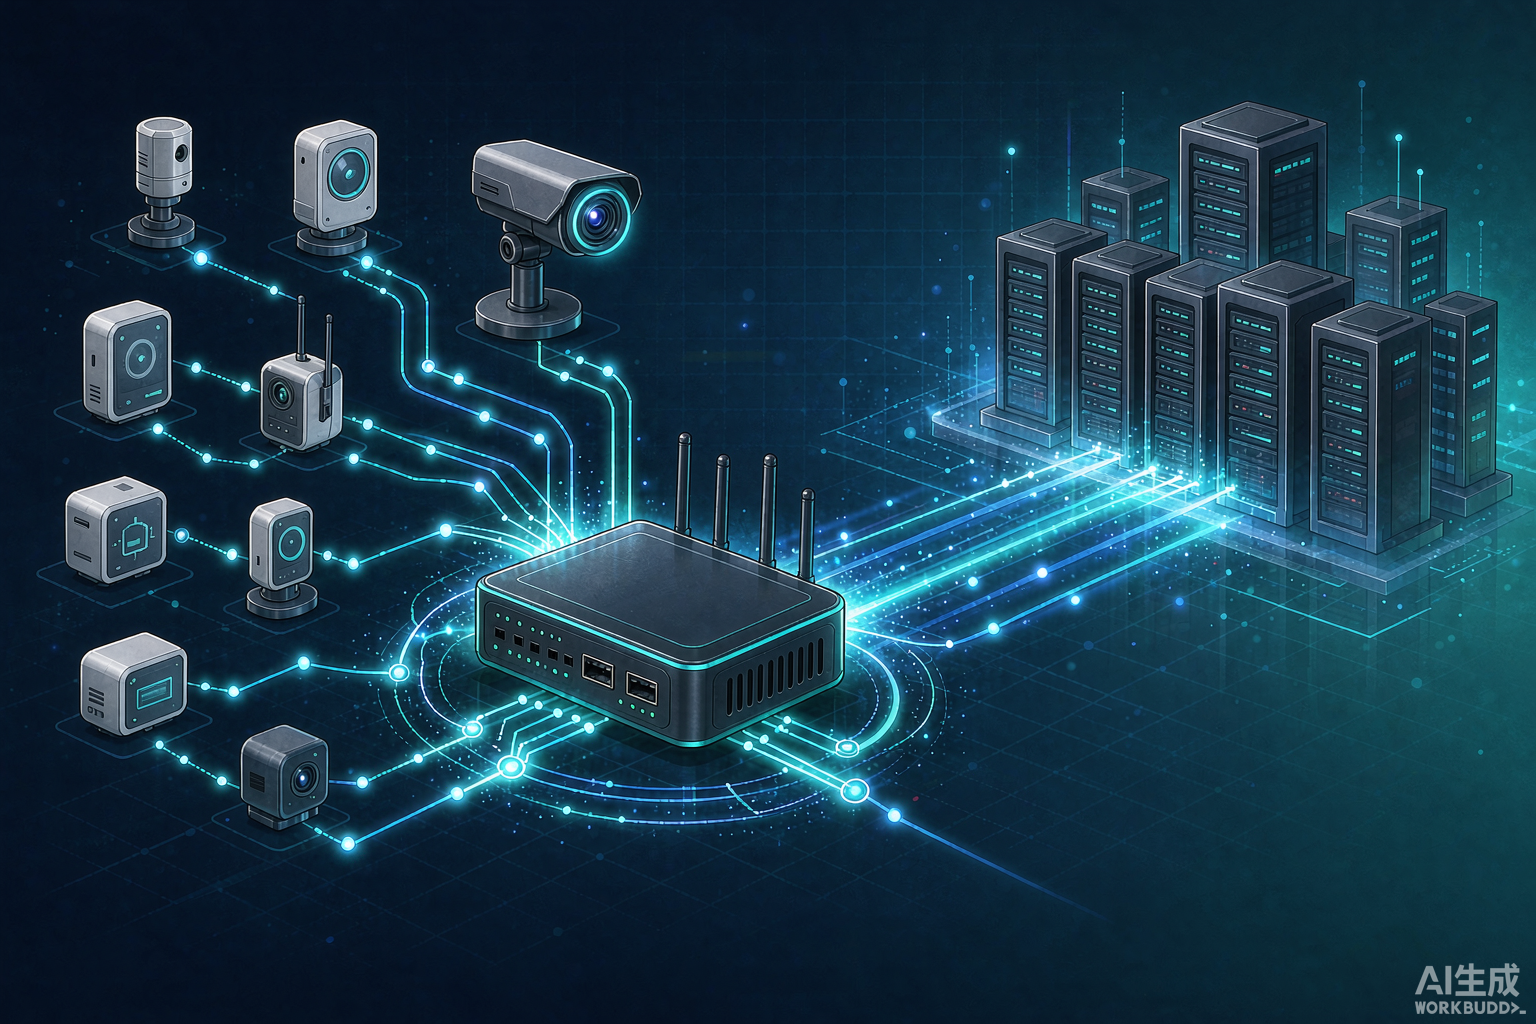
制造、电力、轨道交通等行业普遍面临同样的约束:数据不能轻易离开现场,设备要求7×24小时运行,网络条件难以保证。端侧大模型把推理能力下沉到终端,让质检、巡检、运维这类高频场景不再依赖云端往返。
云端负责训练与知识沉淀,端侧负责实时响应——"云边端"协同正在成为政企智能化的标准架构。
断网可用,是智能从演示走向生产的分界线。
- 来源
- 公开报道整理
- 作者
- 行业研究组